壹 前言
隨著延展實境 (Extended Reality, XR)與數位擬真人的技術發展,3D 虛擬角色已經逐漸出現在導覽、教育、客服與遠距互動等應用場景。不過,當使用者實際與這些虛擬角色 (Avatar)進行互動時,若虛擬角色的表情與動作和語音節奏不一致,也容易呈現出不自然感。
為了改善這項問題,近年來人工智慧開始被用來從語音的節奏、語調及情緒起伏,推論出對應的表情與動作。本文將介紹聲音驅動 3D Avatar 技術的發展原理,也會說明聲音驅動 3D Avatar的應用情境、目前面臨的挑戰,以及未來可能的發展方向。
貳 科技發展現況
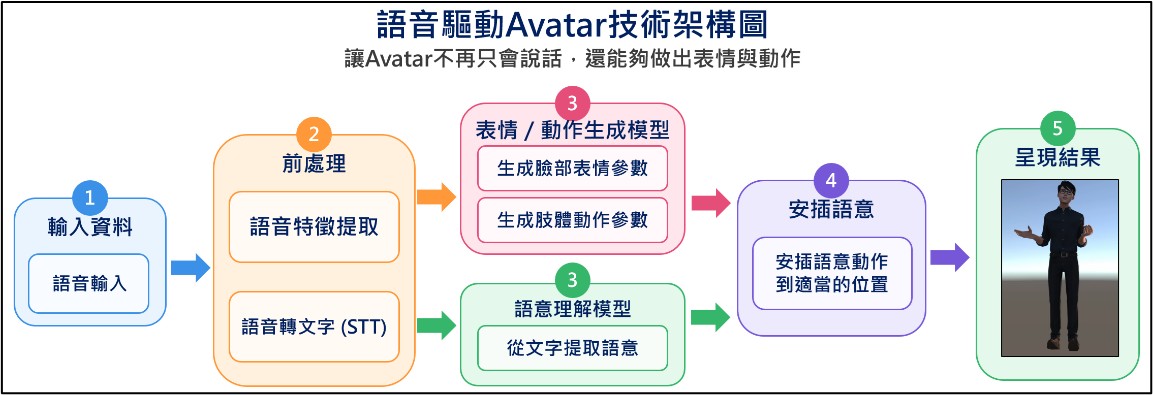
如圖一所示,聲音驅動Avatar臉部表情與肢體動作,是透過語音的輸入,從中提取和表情與動作有關聯的資訊,藉以推論出和說話內容相符的表情與動作,能夠使虛擬角色的表現更加自然。
一、聲音驅動表情動作的技術演進
早期的嘴型同步 (Lip Sync)技術,主要是根據簡單的聲學特徵,對應預先定義的嘴型;部分系統也會搭配預先製作的動作,讓虛擬角色在說話時產生基本的動態表現[1]。不過,真人說話時的表情與動作並不只受到嘴型或音量影響,還會隨著語速、重音、停頓、語調、情緒,以及個人的說話習慣而產生細微變化。因此,單純依靠固定規則或預先定義的動畫,往往只能呈現有限且重複的動作模式,較難呈現真人說話時自然且連續的表情與動作變化。
隨著人工智慧發展,聲音驅動系統開始能直接從語音特徵中學習聲音與表情、頭部及肢體動作的關聯,並生成相應的表情與動作,改變了虛擬角色原先僅能進行「固定嘴型與預設動畫切換」的方式,進一步實現了「根據語音內容與說話方式自動生成動態表現」[2][3]。
二、聲音驅動表情動作,需要使用哪些關鍵技術
(1) 從語音中提取有用的資訊
從技術層面來看,聲音驅動技術的第一步驟是從聲音中提取可利用的資訊,由於語音本身的音高、音量、語速、韻律和情緒等資訊,能夠作為臉部動畫的產生依據,在傳統方法,這些資訊常仰賴人工模擬人耳聽覺特性的梅爾頻率倒譜係數 (Mel-Frequency Cepstral Coefficients, MFCC)作為聲音驅動的聲學特徵,現在則逐漸採用WavLM (Waveform Language Model)等自動提取語音特徵的語音模型[4] [5]。
(2) 以臉部形變描述臉部表情與肢體動作
在過去,模型需要直接推論臉部的大量頂點座標,學習與計算較為複雜,而蘋果公司在2017年推出的ARKit臉部形變 (ARKit Face Blendshapes),使用了52個數值介於0% ~ 100%的形變參數描述眨眼、張嘴等表情,參數改變的過程將會帶動臉部表情對應的頂點座標,由於僅需控制52種參數,無須推論大量頂點座標,可大幅減少訓練參數,已逐漸成為驅動臉部表情的標準[6][7]。
肢體動作方面,通常以骨架關節的位置或旋轉來表示。而BVH (BioVision Hierarchy)是常見的骨架動畫交換格式之一,且容易與語音時間對齊,適合應用在語音驅動肢體動作的動畫上。
(3) 上下文關係與語意
真人在說話時,表情與動作並不只受到當下聲音的音高、音量或節奏影響,也與一句話前後的語意及對話情境有關。例如說出「我不知道」時,除了聲音本身的特徵外,「不知道」所代表的語意,也可能對應到搖頭等動作。因此,若系統僅根據短時間的聲音特徵產生動作,也未必能產生符合語意的表情與手勢。
為了解決這項問題,近年的研究開始結合上下文與語意資訊。並利用變換器 (Transformer)來學習語音、文字與動作間的時序關聯;此外,模型也加入了文字內容與說話者身分,以提升動作生成的自然度與個人化表現[8]。
另一方面,同一句話可能對應多種合理動作。例如問候時,有人揮手、有人點頭。因此,近年研究也開始採用擴散模型 (Diffusion Model)等生成方法,讓系統在符合語音與語意的前提下,產生多樣化且自然的動作表現,而非每次輸出相同結果。
三、聲音驅動臉部表情與動作的應用情境與效益
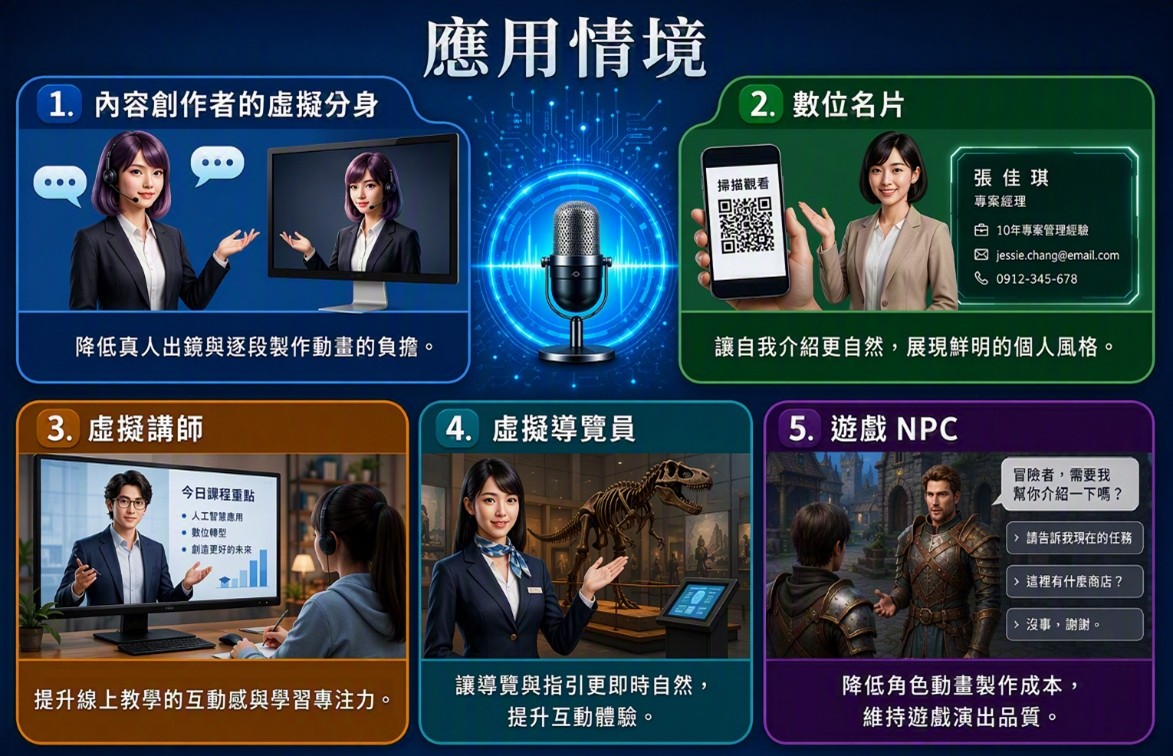
如圖二所示,聲音驅動表情與動作,可應用於虛擬分身、數位名片、虛擬講師、虛擬導覽員,以及遊戲 NPC (Non-Player Character)等情境。相較於傳統預先設定的表情與動作,此技術不僅能減少人工製作的負擔,也能讓虛擬角色在不同情境中呈現更自然的互動方式。
(1) 內容創作者的虛擬分身
內容創作者在製片時,往往需要事先準備拍攝設備、服裝與場景,並進行剪輯與後製;若使用虛擬分身,則需額外製作角色的表情與動作動畫,才能讓畫面具有自然的表現力。
在導入聲音驅動技術後,創作者只需提供語音內容,系統便能依據說話的節奏、語氣與內容,自動產生相對應的表情與動作,減少持續真人出鏡及逐段製作角色動畫的負擔[9]。
(2) 數位名片
傳統的數位名片,僅利用靜態的圖文呈現個人資訊,而在加入Avatar後的數位化名片,使用者只要掃描二維條碼 (quick-response code, QR Code),便可觀看數位分身進行的自我介紹。
結合聲音驅動技術後,介紹的內容就更能以自然且具有個人風格的表達方式呈現,而不再只是播放預錄的聲音。使數位名片相比靜態名片,更能在個人履歷、商務交流與展覽會等場合上,更能夠成為具識別度的展示介面。
(3) 虛擬講師
許多數位教學因為沒有講師在場,僅有螢幕,學生需要依靠自身的動力來學習。能做出表情和動作的虛擬講師有助於改善此問題,虛擬講師除了能講解課程內容,還能夠即時與學生對話,讓數位教學不再只是讓學生被動地接收訊息,進而提高學習的專注力[10]。
(4) 虛擬導覽員
博物館、展覽與機場等場所的虛擬導覽員,不僅需要回答使用者的問題,也需透過表情與動作傳達資訊。導入聲音驅動技術後,角色可根據回答內容,自動產生相對應的表情與動作,例如在介紹展品時搭配說明手勢,或在指引方向時產生相對應的指向動作,使導覽的互動過程更自然。
隨著即時對話應用的發展,表情與動作能否同步產生,也逐漸成為影響互動體驗的重要因素。如果角色已經開始回答問題,但表情或肢體動作在一段時間後才出現,便容易產生語音與動作不同步的情況。因此,降低聲音驅動模型的推論延遲,讓角色能在說話的同時持續產生相符的表情與動作,也將是未來虛擬導覽應用持續發展的重要方向[11]。
(5) 遊戲NPC
在3D的角色扮演遊戲 (Role-playing game, RPG)中,由於讓大量的非玩家角色(Non-Player Character, NPC)支援表情與動作的變化,需要投入高額製作成本,因此多採用固定的嘴型或重複的預設動作,在導入聲音驅動表情與動作的技術後,可依據預錄語音自動生成相應的表情與動作,讓遊戲內的NPC說話時,能夠維持一定的演出品質[12]。
四、重要的挑戰
儘管聲音驅動表情與動作具有發展的潛力,不過在實際部署時仍面臨許多挑戰。其中,延遲是影響互動自然度的重要因素之一,如果系統必須取得完整語音後才能生成表情與動作,語音與動作之間便容易出現明顯的時間落差。
此外,個人風格與語意的一致性也是重要的研究課題,若角色說「在右邊」時能指出正確的方位,而非原先在一般對話時做出的手勢,且在不同人的說話習慣上能表現出多樣性,將能夠讓虛擬角色的表現更自然且具有一致性。
五、未來三年的發展方向
未來幾年,聲音驅動Avatar 很可能朝低延遲串流推論、個人化及結合語意的方向發展。低延遲技術可讓角色邊說話邊持續產生動作,無需等待完整的語音輸入後才進行推論;而結合語音特徵、文字語意與個人動作習慣的模型,更有助於生成符合語意且具個人風格的表情與動作。
參 結語
更低延遲及高表現力的表情與動作生成,已成為語音驅動 Avatar 的重要發展趨勢。其應用範圍也逐漸從單純的影片製作,延伸到數位名片、虛擬業務員、講師、導覽員等,在未來,中華電信將持續整合既有技術,朝低延遲與高表現力的方向發展,並進一步導入數位名片、企業服務、教育與導覽等實際應用場景,提升虛擬角色表情與動作的自然度,使其成為更具互動性的數位服務介面。
肆 參考文獻
[1] Jiang, D.; Chang, J.; You, L.; Bian, S.; Kosk, R.; Maguire, G. Audio-Driven Facial Animation with Deep Learning: A Survey. Information 2024, 15, 675. https://doi.org/10.3390/info15110675
[2] Cudeiro, D. et al. Capture, Learning, and Synthesis of 3D Speaking Styles. CVPR 2019, 10101–10111. https://doi.org/10.1109/CVPR.2019.01034
[3] Yi, H. et al. Generating Holistic 3D Human Motion From Speech. CVPR 2023, 469–480. https://doi.org/10.1109/CVPR52729.2023.00053
[4] Zhang, F.; Wang, Z.; Lyu, X.; Ji, N.; Zhao, S.; Gao, F. DiT-Gesture: A Speech-Only Approach to Stylized Gesture Generation. Electronics 2024, 13, 1702. https://doi.org/10.3390/electronics13091702
[5] Chen, S. et al. WavLM: Large-Scale Self-Supervised Pre-Training for Full Stack Speech Processing. IEEE Journal of Selected Topics in Signal Processing 2022, 16(6), 1505–1518. https://doi.org/10.1109/JSTSP.2022.3188113
[6] Inkyu Park, Jaewoong Cho, “SAiD: Speech-driven Blendshape Facial Animation with Diffusion”, arXiv preprint arXiv:2401.08655, 2023.
[7] Apple Inc. “blendShapes.” ARKit Developer Documentation. https://developer.apple.com/documentation/arkit/arfaceanchor/blendshapes
[8] Liu, L.; Ghaleb, E.; Özyürek, A.; Yumak, Z. “SemGes: Semantics-aware Co-Speech Gesture Generation using Semantic Coherence and Relevance Learning.” Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV), 2025, pp. 13963–13973.
[9] Kwebbelkop開始利用AI來代替自己:是否能讓創作者告別倦怠期?Harris Chang, 2023
https://tenten.co/learning/youtuber-kwebbelkop-ai/
[10] Davis, R. O. “The Impact of Pedagogical Agent Gesturing in Multimedia Learning Environments: A Meta-Analysis.” Educational Research Review, 2018, 24, 193–209. doi: 10.1016/j.edurev.2018.05.002.
[11] Jolibois, S. C.; Ito, A.; Nose, T. “The Development of an Emotional Embodied Conversational Agent and the Evaluation of the Effect of Response Delay on User Impression.” Applied Sciences, 2025, 15(8), 4256. DOI: 10.3390/app15084256
[12] Nyatsanga, S.; Kucherenko, T.; Ahuja, C.; Henter, G. E.; Neff, M. “A Comprehensive Review of Data-Driven Co-Speech Gesture Generation.” Computer Graphics Forum, 2023, 42(2), 569–596. DOI: 10.1111/cgf.14776.