壹 前言
Gemini、Claude、Llama等大型語言模型(Large Language Models, LLMs)快速發展,帶動生成式人工智慧(Generative AI)從技術驗證階段走向大規模商業應用,廣泛應用於智慧客服、文件生成、知識檢索、程式開發及多媒體內容創作等領域。應用數量與使用規模的快速成長,也使AI系統的關注重點逐漸由模型訓練(Training)轉向模型推論(Inference)。
依據Presenc AI彙整的產業分析結果,推論相關運算成本占整體AI運算成本的80%以上[1]。對多數生成式AI服務來說,推論成本已成為服務營運階段的重要支出,因此如何以更高效率的方式提供推論服務,在降低延遲的同時提升吞吐量與資源利用率,已成為當前AI基礎設施與推論技術發展的核心方向。
Agentic AI、長上下文(Long Context)及多模態模型的興起[2],使單一使用者請求往往需要更多模型互動與運算資源,增加推論服務的效能與成本壓力。面對持續增長的使用需求,如何選擇合適的服務模式,並透過推論技術改善資源使用效率與服務效能,已成為企業發展生成式AI應用時需要關注的重要議題。
貳 模型推論現況
一、 雲端算力服務模式
常見的雲端算力服務包括GPUaaS (GPU-as-a-Service)[3]與TaaS(Token-as-a-Service)[4],如圖1所示,兩者適用於不同的使用情境。GPUaaS是以雲端虛擬主機或GPU使用時數來計價,企業可自行配置底層硬體與軟體環境,適合需客製化參數調整、環境掌控需求高的任務;TaaS則將模型推論服務封裝為API,依實際使用的Token數量計費,企業無須自行建置與維護推論環境,較適合快速迭代及流量變化較大的應用。目前,中華電信算力雲管已提供GPUaaS服務模式,並逐步發展TaaS服務,以滿足企業從算力租用到模型推論的不同需求。
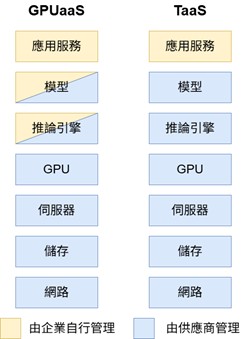
無論採用GPUaaS或TaaS,模型的回應速度與服務成本都與推論效率有關。後續將從大型語言模型產生回應的過程,進一步說明推論服務面臨的問題。
二、 大型語言模型如何產生回應
現行推論涵蓋文字生成、影像辨識與語音處理等不同應用方式。考量目前生成式AI主流以對話問答、內容生成與知識檢索等語言互動為主,本文將聚焦於大型語言模型的推論技術。
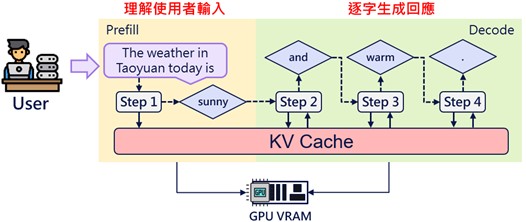
其推論流程可分為兩個階段[5],如圖2所示。第一個階段稱為Prefill,模型會先讀取並處理使用者輸入的完整內容,並生成要回應的第一個字;第二個階段稱為Decode,模型會根據前一階段的處理結果,逐步產生後續文字,直到完成回應。
為避免每次產生新內容時都重新處理先前資訊,模型會將運算結果以KV Cache形式暫存於GPU的VRAM中,可將其理解為模型產生回應時的「暫存記憶」。當輸入內容越長,或同時進入的請求數量越多,KV Cache所需的VRAM空間也會增加,進而影響系統可同時處理的請求數量與回應速度。
三、 現行推論面臨議題
大型語言模型的規模與服務需求增長,使現行推論架構容易面臨以下兩個議題[6, 7]:
(一) VRAM容量不足
推論執行時,模型本身、KV Cache及運算資料皆會占用VRAM。模型越大、輸入內容越長或同時使用人數越多,所需的VRAM空間也會增加。當空間不足時,可處理的內容長度與請求數量皆會受限,可能增加等待時間。因此,如何減少KV Cache占用的空間,或將部份資料轉移至其他儲存層級,是推論的重要改善方向。
(二) 推論階段(Prefill/Decode)相互干擾
Prefill與Decode通常共用相同的運算資源,但兩者的工作方式不同。Prefill需先處理使用者輸入的完整內容,Decode則負責逐步產生回答。當大量或較長的請求同時進入系統時,Prefill可能占用較多資源,影響正在執行的Decode,造成回應速度不穩定。
增加推論副本雖可分散請求並提高服務量,但各副本內的Prefill與Decode仍會競爭資源。因此,如何依據兩個階段的特性分別配置與調度資源,已成為推論架構發展的方向之一。
參 模型推論發展趨勢
為改善VRAM容量不足與Prefill、Decode相互干擾等問題,近年推論技術開始從資料儲存與資源配置著手。本文整理其中兩項發展方向:一是用於降低VRAM使用量的KV Offload(KV快取卸載)與TurboQuant(KV壓縮)技術,二是採用Prefill/Decode分離架構,減少兩階段間的資源干擾,以下將分別進行介紹。
一、 降低VRAM使用量
(一) KV Offload
KV Offload[8]主要用於緩解VRAM容量不足。此技術將暫時不用的KV Cache移出VRAM,釋放空間,待需要時重新載入。而可供KV Cache儲存的位置,目前主要有VRAM、RAM與NVMe SSD三類,如表1所示。
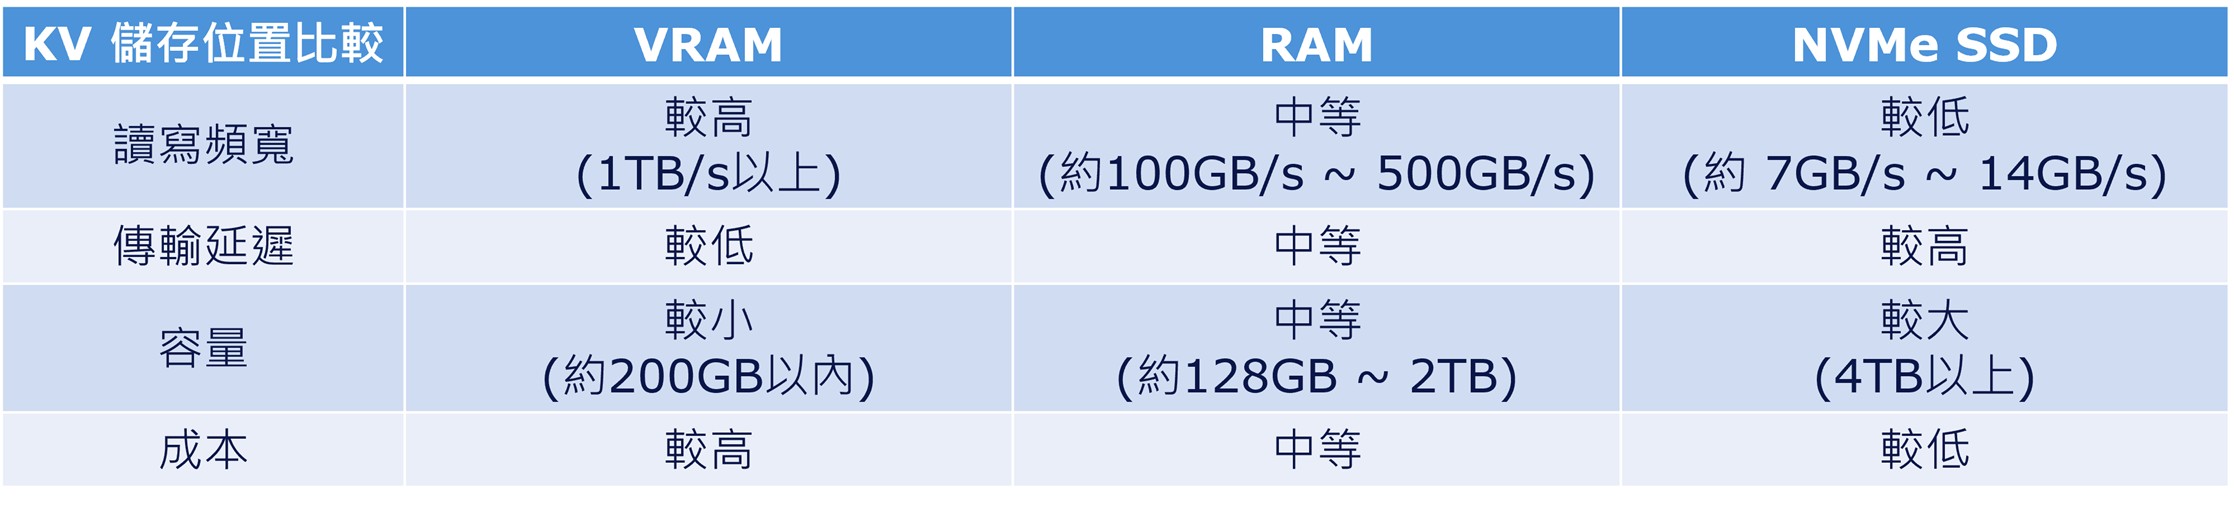
KV Cache通常存放於高頻寬、低延遲的VRAM,但其容量有限且不易擴充,因此在長上下文或高併發時容易形成瓶頸。
而當VRAM不足時,可將部份KV Cache卸載至RAM,雖然頻寬與延遲不如VRAM,但其優勢在具有更大的容量且可進行擴充;若面對的是超長上下文,也可進一步將KV Cache卸載至容量較大的NVMe SSD,並搭配GPUDirect Storage[10]來降低資料搬移成本。
(二) TurboQuant
除了將KV Cache移出VRAM,也可透過壓縮的方式降低其VRAM用量與卸載頻率。Google Research團隊於2026年提出的TurboQuant[11],即是相關技術之一。
在傳統的量化過程中,數值分布往往存在極端巨大的離群值(Outliers)[12],這些離群值會擴大數值範圍,使低位元量化更容易產生誤差。而TurboQuant的核心原理是透過數學上的運算,將這些少數的尖峰平均分攤到各個維度上。當資料分布被平滑化後,就能在維持模型品質的情況下,將記憶體空間縮減高達6倍,並壓縮至3-bit的精度,並能夠在GPU需要取用時將其解壓縮進行還原,使相同VRAM空間可保存更多KV Cache。
二、 Prefill與Decode分離架構(PD Disaggregation)
為解決Prefill與Decode共用運算資源時產生的互相干擾,業界開始探討將兩個推論階段分開部署。其中,Splitwise[13]與DistServe[14]這兩篇論文是Prefill與Decode分離架構的早期代表性研究,說明兩個階段在運算特性與資源需求上的差異,並提出將兩者部署於不同運算資源、透過KV Cache傳輸銜接推論流程的基本架構。
如圖3所示,左側為傳統單體式架構(Monolithic Inference),Prefill與Decode共用相同算力資源,共享相同GPU VRAM中的KV Cache,此架構較為單純,且不需額外搬移KV Cache,因此在低併發或短上下文情境下可減少傳輸與調度開銷。然而,在併發數高且輸入上下文長時,則會因為Prefill與Decode資源互搶而導致TTFT(Time to First Token)與TPOT(Time per Output Token)波動,使延遲與服務穩定性受到影響。
右側為Prefill/Decode分離架構,透過將兩個階段配置於不同的GPU及推論實例,使Prefill與Decode依各自的工作特性獨立執行,並透過推論池設計分散高併發請求。Prefill完成運算後,需將產生的KV Cache傳送至Decode實例,接續Token的生成。KV Cache傳輸可透過NIXL(NVIDIA Inference Xfer Library)[15]等傳輸函式庫實現;在同一節點內,可利用NVLink[16]進行GPU間的高速資料傳輸,跨節點則可透過RDMA[17]網路進行傳輸,降低KV Cache搬移所產生的延遲。
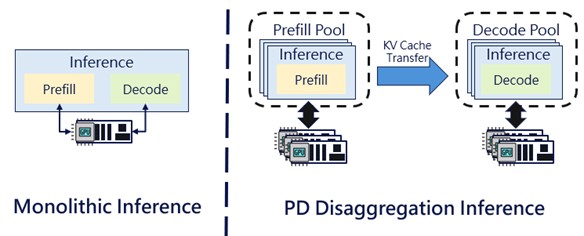
Prefill/Decode分離架構可依輸入長度、輸出長度及服務負載分別配置資源,降低兩階段間相互干擾程度,也能提高擴充彈性與高併發情境下的服務穩定性。不過,PD分離也會增加KV Cache傳輸與跨實例調度的成本,實際效益取決於模型規模、請求與應用特性、系統負載及網路傳輸能力等因素。
肆 結語
隨著生成式AI與大型語言模型持續發展,模型推論面臨VRAM容量不足、Prefill與Decode資源競爭及推論成本增加等挑戰。本文介紹的KV Offload、TurboQuant與Prefill/Decode分離架構,分別從記憶體管理、資料壓縮及資源配置等面向改善推論效率。
上述相關技術同樣也作為中華電信算力雲管發展模型推論服務時的導入方向與技術參考,期望透過軟硬體協同設計,逐步提升資源利用率、系統擴充性與服務穩定性,以支援持續成長的生成式AI推論需求。
伍 參考文獻
[1] Inference vs Training Compute Split, July 2026, Available at: https://presenc.ai/research/inference-vs-training-compute-split-2026
[2] Enterprise Generative AI Development: From PoC to Production — LLM, RAG & Agent, Available at: https://www.meta-intelligence.tech/en/cap-genai
[3] GPU As A Service Market (2026 - 2033), Available at : https://www.grandviewresearch.com/industry-analysis/gpu-as-a-service-gpuaas-market-report
[4] Building Token‑Metered AI Services on Telco AI Factories, Available at: https://developer.nvidia.com/blog/building-token-metered-ai-services-on-telco-ai-factories/
[5] LLM Inference Serving: Survey of Recent Advances and Opportunities, Available at: https://www.researchgate.net/publication/382331612_LLM_Inference_Serving_Survey_of_Recent_Advances_and_Opportunities
[6] Accelerate Large-Scale LLM Inference and KV Cache Offload with CPU-GPU Memory Sharing, Available at: https://developer.nvidia.com/blog/accelerate-large-scale-llm-inference-and-kv-cache-offload-with-cpu-gpu-memory-sharing
[7] Next-Level Inference: Why Your Single-Node vLLM Setup Needs Prefill-Decode Disaggregation, Available at: https://vllm-project.github.io/2026/04/07/moriio-kv-connector.html
[8] Example: Offload KV cache to CPU, Available at: https://docs.lmcache.ai/getting_started/quickstart/offload_kv_cache.html
[9] GPU Memory Hierarchy — How AI Training Actually Works, Available at: https://medium.com/@indiai/gpu-memory-hierarchy-how-ai-training-actually-works-24f00cc13050
[10] Nvidia GPUDirect Storage Automatic Prefix Caching, Available at: https://docs.nvidia.com/gpudirect-storage/
[11] TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate, 2026, Available at: https://iclr.cc/virtual/2026/poster/10006985
[12] LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale, Available at: https://dl.acm.org/doi/10.5555/3600270.3602468
[13] Splitwise: Efficient Generative LLM Inference Using Phase Splitting, Available at: https://dl.acm.org/doi/10.1109/ISCA59077.2024.00019
[14] DistServe: disaggregating prefill and decoding for goodput-optimized large language model serving, Available at: https://dl.acm.org/doi/10.5555/3691938.3691949
[15] Enhancing Distributed Inference Performance with the NVIDIA Inference Transfer Library, Available at: https://developer.nvidia.com/blog/enhancing-distributed-inference-performance-with-the-nvidia-inference-transfer-library/
[16] NVLink & NVLink Switch: Fastest HPC Data Center Platform | NVIDIA, Available at: https://www.nvidia.com/en-us/data-center/nvlink/
[17] PD disaggregation — Infera 0.1, Available at: https://rocm.docs.amd.com/projects/infera/en/latest/features/pd_disaggregation.html#cross-node-prerequisites-rdma