近年生成式AI技術快速發展,已廣泛應用於智慧客服、知識問答及內容創作等場域。然而,隨著AI應用普及,AI系統也面臨更多安全威脅。使用者可能透過提示詞注入(Prompt Injection)、越獄(Jailbreaking)等手法,誘導模型繞過既有安全限制;AI也可能生成有害、不當、協助犯罪,或不符合組織規範的內容,進而衍生資訊安全、法規遵循及品牌聲譽風險。因此,如何從輸入到輸出建立完整的AI安全防護機制,已成為生成式 AI 落地與治理的重要課題。
綜觀國際AI安全與風險治理發展趨勢,主要業者及組織除積極投入相關技術研發,也陸續制定技術框架。例如,開放網路應用程式安全計畫(OWASP)發布「OWASP Top 10 for LLM Applications」,整理大型語言模型應用常見的安全風險,包括提示詞注入、敏感資訊洩漏、供應鏈風險及不安全輸出處理等攻擊面[1];Gartner則提出AI TRiSM(AI Trust, Risk and Security Management)技術框架,強調從AI可信任性、風險管理及安全性等面向建立完整治理機制[2]。有鑑於此,中華電信研究院在規劃AI技術發展藍圖時,也將AI安全合規列為重點項目,積極掌握國際AI安全與風險治理趨勢。
然而,現有大型語言模型之安全防護與評測機制,多以英文語料及英語文化情境為主要基礎,對非英語地區的語言特性、文化脈絡及在地風險情境涵蓋仍有限,對臺灣在地語言及文化情境的支援可能出現較高的安全辨識落差[3]。例如臺灣使用者常見的本土語言混用、注音符號、網路流行語及在地隱喻等表達方式,可能影響AI對攻擊行為及風險內容的辨識效果,也增加企業與組織導入AI應用時的安全及合規挑戰。因此,除了通用的AI安全防護能力外,如何進一步因應不同地區的語言、文化及使用情境,建立符合在地需求的AI安全防護能力,成為可信任AI發展的重要課題。
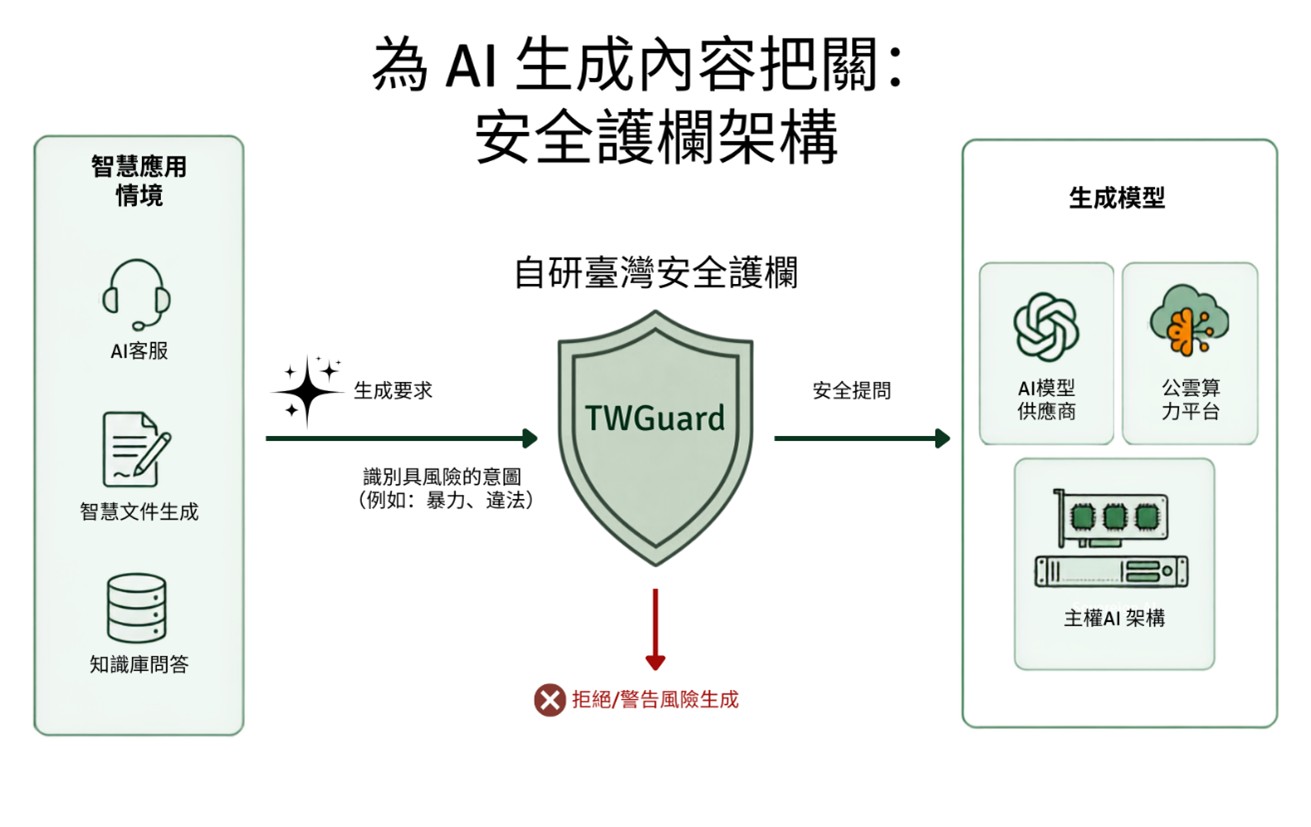
為加速可信任AI落地,中華電信研究院投入在地AI風險治理技術研究,自主研發以數萬筆在地語料訓練的AI安全護欄模型TWGuard。TWGuard如同AI應用的防火牆,在使用者要求傳遞給AI模型之前,先辨識可能的高風險要求,主動偵測可能涉及敏感內容、犯罪行為、違法建議及色情等不當內容,協助降低AI應用遭受攻擊及產生不當輸出的風險。
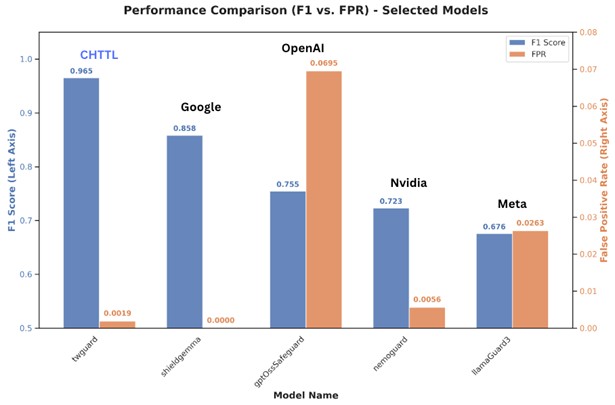
TWGuard 專為臺灣應用情境設計,在提升風險內容辨識能力的同時,亦兼顧低誤判率(False Positive Rate, FPR),降低正常使用情境遭誤判而影響使用者體驗的情形,提供更符合臺灣實際應用需求的AI安全防護方案。透過在地語言及文化情境的訓練,TWGuard可補足通用型AI安全模型對臺灣特有表達方式與風險情境辨識能力的不足。
中華電信研究院根基於多年電信級基礎建設,以及支援公部門ICT服務所累積的實務經驗,從技術研發初期即納入實際部署所需的效能、資源及整合需求。TWGuard採模組化設計,可整合至企業AI助理、智慧客服、知識問答及AI Agent等應用,並支援不同AI模型供應商、公有雲及主權AI部署架構,協助企業與組織快速建構AI安全治理能力。
本項研發成果除作為本公司「海地星空、網路韌性、AI永續」生態系的重要技術基礎,亦將持續精進AI安全護欄技術研發,接軌國際AI治理趨勢,深化我國可信任AI技術發展,持續守護臺灣AI安全。
參考文獻:
[1]. OWASP GenAI LLM Top 10 2026. August 3, 2026. Available at: https://genai.owasp.org/resource/owasp-genai-llm-top-10-2026/.
[2]. Govern AI Using TRiSM: The Technical Framework for Trust, Risk, and Security. 1 October 2025. Available at: https://www.gartner.com/en/documents/7009298.
[3]. CultureGuard: Towards Culturally-Aware Dataset and Guard Model for Multilingual Safety Applications. December, 2025. Available at: https://aclanthology.org/2025.ijcnlp-long.144/.